Atendente de IA no WhatsApp de um consultório médico
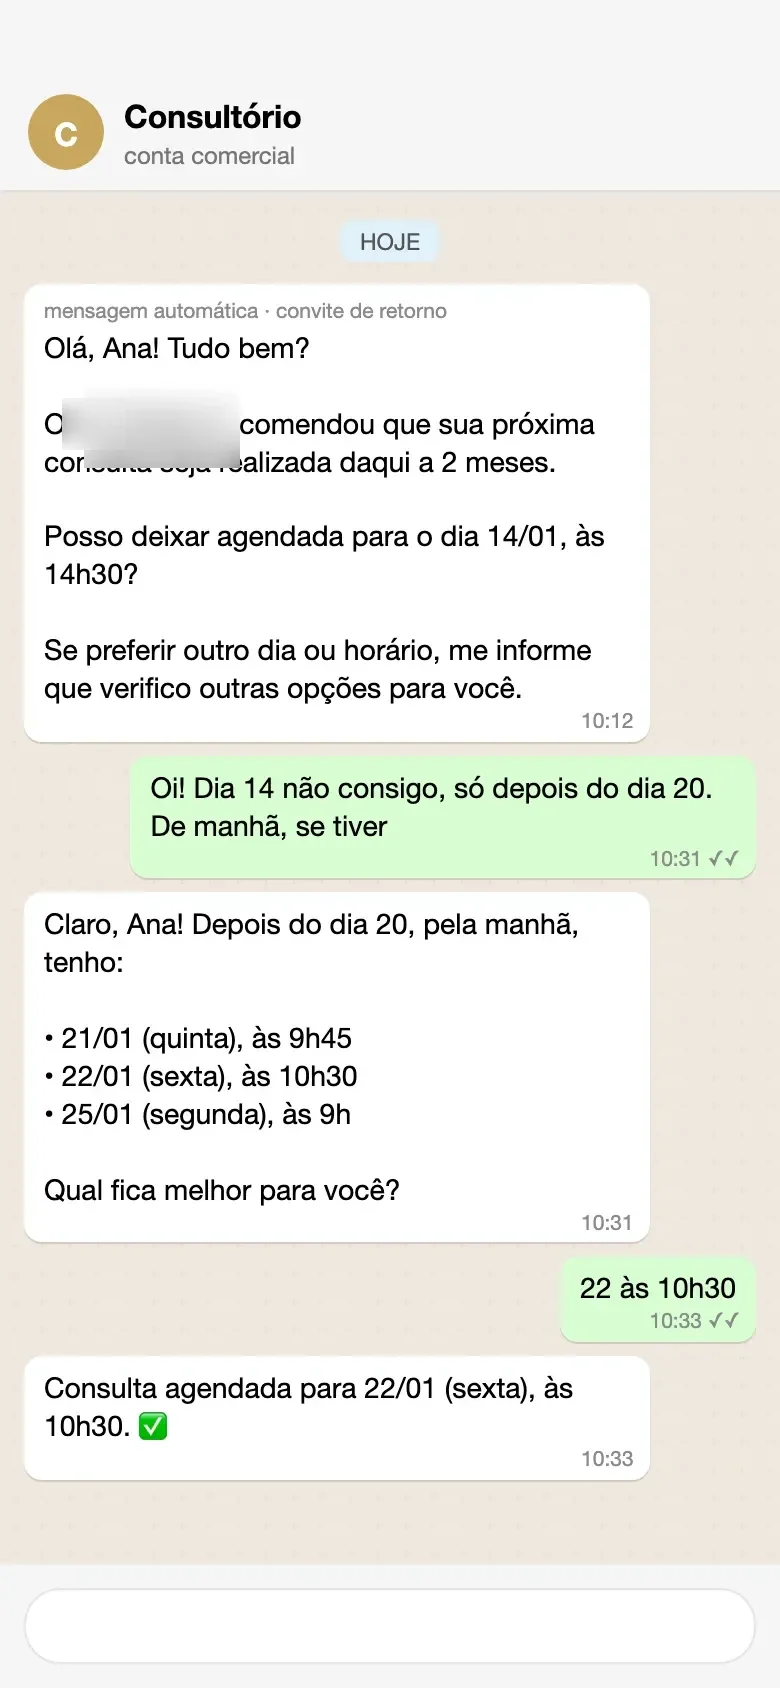
Responde pacientes à noite e no fim de semana, agenda, remarca e confere pagamentos, e passa para a equipe o que precisa de uma pessoa.
Consultório médico. Em produção. Desde jun. de 2026.
- 2.500+
- mensagens por mês respondidas pela IA
- 74,5%
- a menos de custo por mensagem
- 49
- situações de risco testadas antes de ir ao ar
- 15 min
- entre uma checagem automática de erros e outra
O problema
Um consultório médico com atendimento online recebia tudo pelo WhatsApp: dúvidas, agendamento, comprovante de pagamento, confirmação, remarcação e convite de retorno. Uma equipe pequena para muita mensagem.
Fora do horário ninguém respondia, a agenda não conversava com o WhatsApp e cada erro custava caro: paciente sem resposta, horário oferecido para duas pessoas, informação errada sobre valores. Um robô comum daria conta do volume, mas poderia inventar justamente o que não pode.
Na prática
Veja a IA ser corrigida antes de responder
O resultado
- Mais de 2.500 mensagens por mês respondidas pela IA, sete dias por semana.
- A secretária passou a receber só os casos que precisam de uma pessoa, já com resumo.
- Cada resposta custa cerca de US$ 0,012 com a economia de custo ligada.
- O mesmo atendente foi adaptado depois para uma clínica com vários profissionais.
O que ficou de aprendizado
Informação importante não pode depender da IA. Uma revisão automática feita por IA chegou a inventar um preço, e desde então preço só sai de tabela conferida.
O painel do WhatsApp não separava o que a IA respondeu do que a equipe respondeu. Para medir o resultado, cada envio passou a ser registrado um a um.
Detalhes técnicosArquitetura, desafios e ferramentas, para quem é da área.
Da mensagem do paciente ao envio: a IA escreve, a Guarda em código decide o que pode sair e a equipe recebe o que precisa de gente.
O agente
- Atende no WhatsApp oficial, segue o roteiro da clínica, tira dúvidas e oferece horários reais da agenda.
- Agenda, remarca e cancela direto na agenda própria do consultório, pela API.
- Lê o comprovante de pagamento por imagem e confirma.
- Agrupa mensagens picadas (espera a pessoa terminar de escrever) e responde uma vez só.
- Respeita janelas de atendimento: quem escreve de madrugada recebe a resposta quando a janela abre.
A Guarda: o modelo escreve, o código decide
- Toda resposta passa por uma revisão em código antes de sair.
- Valor só sai da tabela oficial; qualquer outro número é trocado.
- Qualquer orientação clínica é removida e o caso vai para a equipe.
- Frases proibidas saem; o texto padrão de apresentação e o roteiro de lead novo são obrigatórios.
Humano no circuito
- O agente detecta quando alguém da equipe assumiu a conversa e fica em silêncio.
- Uma nova checagem de humano ativo acontece logo antes de cada envio.
- Crise, exame, pedido fora do roteiro e cobrança fora do padrão vão para a equipe, com resumo pronto.
- Relatório semanal em PDF enviado sozinho ao médico toda segunda.
Desafios
- Trava anti-duplicata atômica no Postgres, para a mesma mensagem nunca gerar duas respostas.
- Reserva antes de oferecer: o mesmo horário não é oferecido a duas pessoas ao mesmo tempo.
- Disjuntor contra loop de ferramenta, com teto por pedido, por 10 minutos, por hora e por dia.
- Publicação bloqueada se o prompt citar uma ferramenta que está desligada (a causa exata de um loop real).
- Lista de invariantes: uma publicação nova não pode desfazer uma correção antiga.
- Piloto com lista de números autorizados antes de abrir para todos.
- Infraestrutura como código: regras críticas versionadas, reconciliação agendada com auto-cura e patches reproduzíveis.
Decisão difícil
Falha de leitura nunca é "fechado"
Quando a consulta à agenda dá timeout, o sistema trata o horário como aberto e confere de novo, em vez de dizer ao paciente que não há vaga. Na dúvida, o erro vai para o lado de atender.
Ferramentas: n8n (VPS própria), Claude API, Prompt caching, Postgres / Supabase, WhatsApp Cloud API, GitHub Actions, Node.js.